https://arxiv.org/abs/2604.09852
MEMENTO: Teaching LLMs to Manage Their Own Context
Reasoning models think in long, unstructured streams with no mechanism for compressing or organizing their own intermediate state. We introduce MEMENTO: a method that teaches models to segment reasoning into blocks, compress each block into a memento, i.e.
arxiv.org
마소 논문입니다.
https://github.com/microsoft/memento
GitHub - microsoft/memento
Contribute to microsoft/memento development by creating an account on GitHub.
github.com
https://huggingface.co/datasets/microsoft/OpenMementos
microsoft/OpenMementos · Datasets at Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co
코드와 데이터 셋도 공개되어 있고요.
Leasoning LLM의 비효율을 세가지로 구분했다.
1. 불필요한 추론 정보 누적
2. 요약시 정보 손실
3. 기존 텍스트 요약 기반 방법은 내부 표현까지 버림
요약문이 만들어질 당시의 문맥화된 KV 상태를 유지한다면 더 많은 추론 정보를 보존할 수 있다고 본다.
먼저 데이터 셋을 제작하네요
-
Sentence Splitting: 수식과 코드 구조를 고려하여 긴 추론을 문장 단위로 나눈다. 수식이나 이어지는 계산을 중간에서 자르지 않도록 처리한다.
-
Boundary Scoring: GPT-5.x를 활용하여 각 문장 경계에 0~3점을 부여한다. 3점은 새로운 추론 단계로 넘어가는 명확한 경계다.
-
Segmentation Optimization: 높은 경계 점수를 우선하면서 각 블록의 길이가 지나치게 불균형해지지 않도록 구간을 구성한다. 블록은 최소 200토큰이다.
-
Memento Generation: 각 구간에 대해 공식, 변수, 중간 결론, 선택한 전략을 보존하는 압축 요약을 생성한다.
-
Judge-based Refinement: 별도의 LLM Judge가 요약의 품질을 10점 만점으로 평가한다. 8점 미만이면 누락된 정보를 피드백하여 재작성한다.
즉 여기서 Memento는 학습된 latent vector가 아닌 정보 밀도가 높은 자연어 텍스트 요약이다.
그렇게 해서 Stage 1때는 Memento를 생성할 수 있도록 학습하고, Stage 2에서는 Memento를 활용해서 이어서 추론하게 된다.
이렇게 학습한 모델로 평가해봤을 때 reasoning 성능을 비교적 유지하면서 KV cache를 줄이게 된다. + 시간 단축도 있었음 But 성능 향상은 없었음 ...
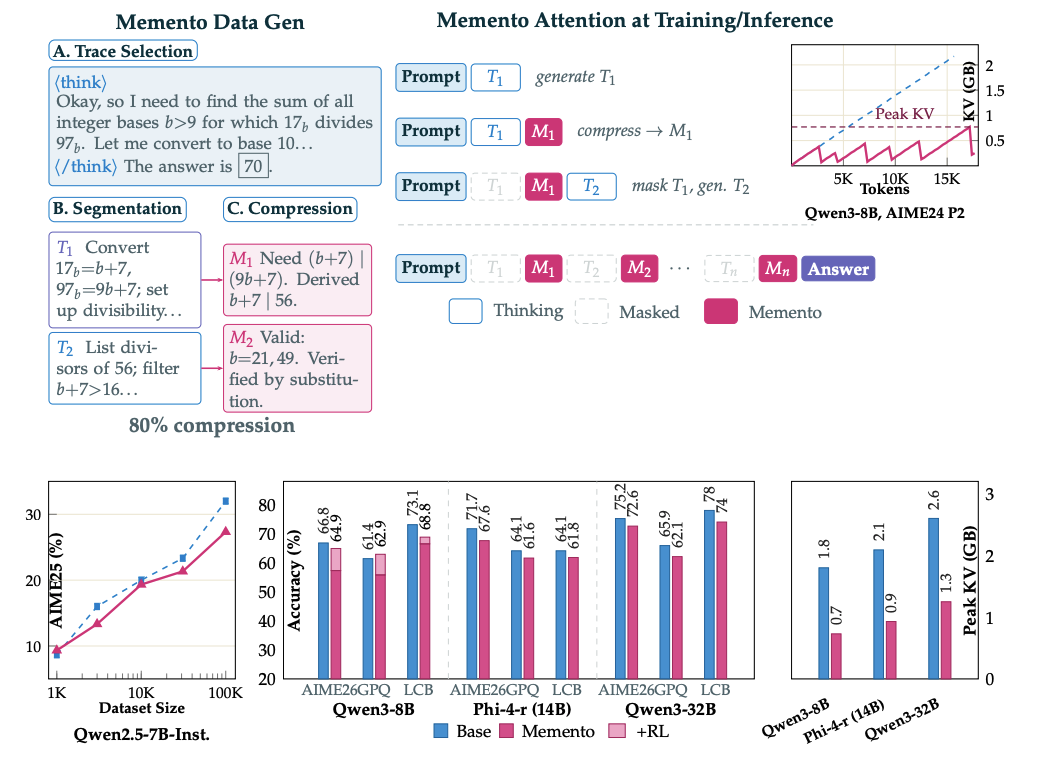
이 그림으로 논문의 전체적인 방향성과 결과를 볼 수 있습니다.
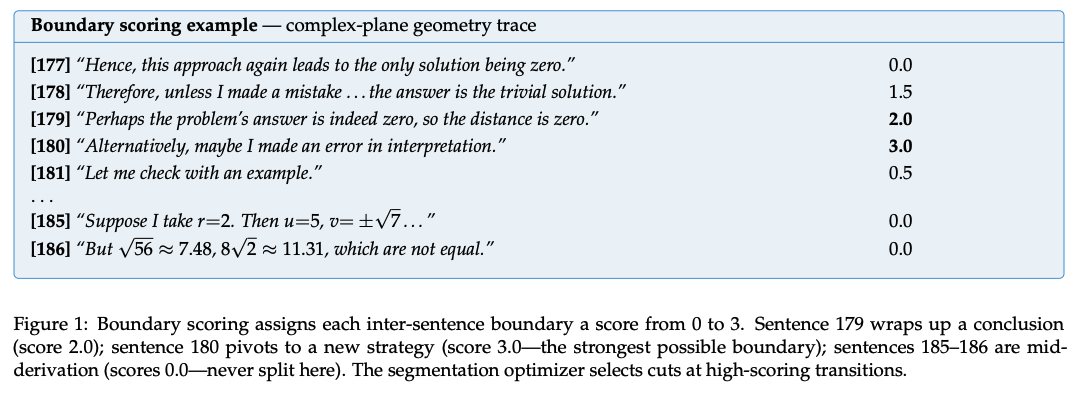
점수를 통해 나누는 것을 볼 수 있다. 3점이 곳에서 나누게 된다.
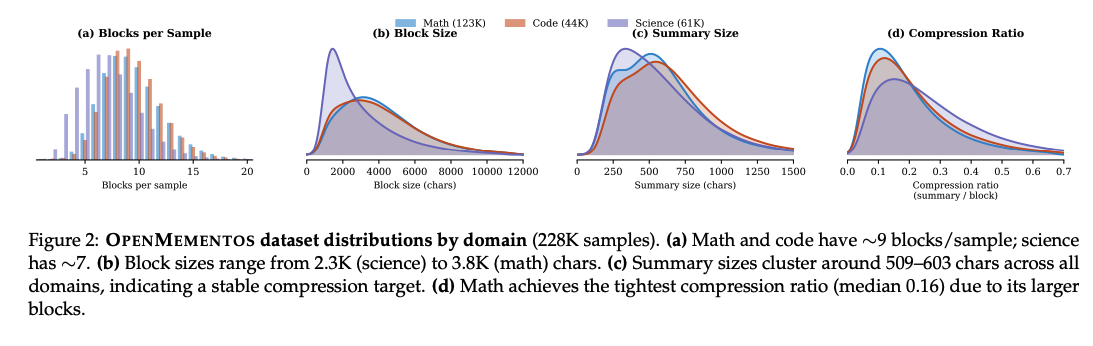
평균적으로 7 ~ 9개의 블록으로 나눠지며 Math는 블록당 3800 캐릭터이고, 과학은 2300이었다.
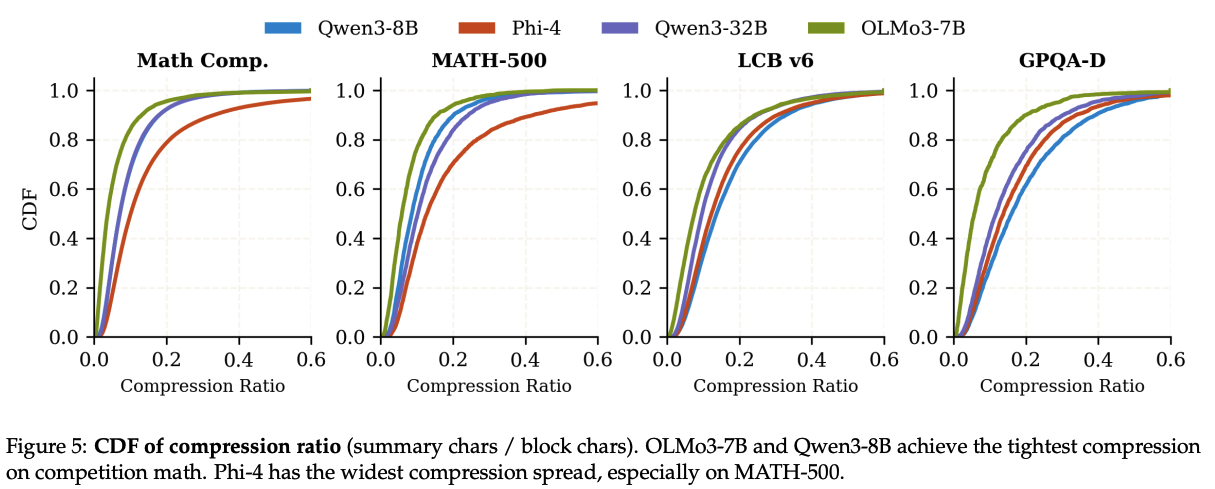
Memento는 509 ~ 603캐릭터로 모이는 것을 볼 수 있다.
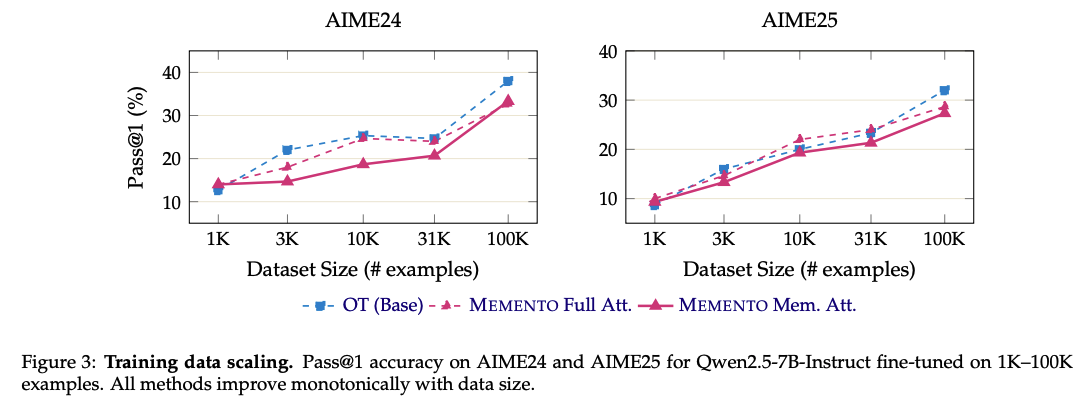
데이터가 많아지면 MEmento의 성능도 올라가지만 일반적인 reasoning SFT보다 약간 낮은 성능을 보인다는 것을 볼 수 있다.
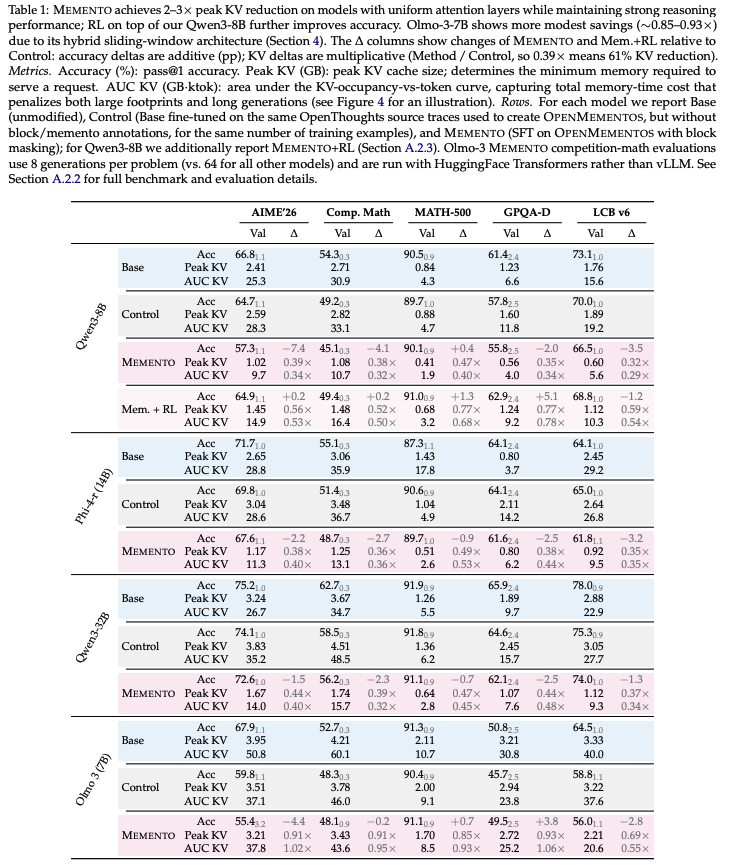
Control 을 통해 단순히 SFT하더라도 성능이 떨어지는 것을 볼 수 있다. - 데이터에 조금 문제가 있긴 하네요 ....
작은 모델일 수록 압축에 의한 성능 손실이 상대적으로 크고, 쉬운 문제에서는 성능 감소가 작으며 RL을 활용하면 정확도를 회복할 수 있는 것을 보여줬다.
메모리도 감소하는 것을 보여주는데 Olmo에서는 이미 Sliding-window Attention을 사용하기에 메모리 절감 효과가 제한되는 것을 볼 수 있었다.
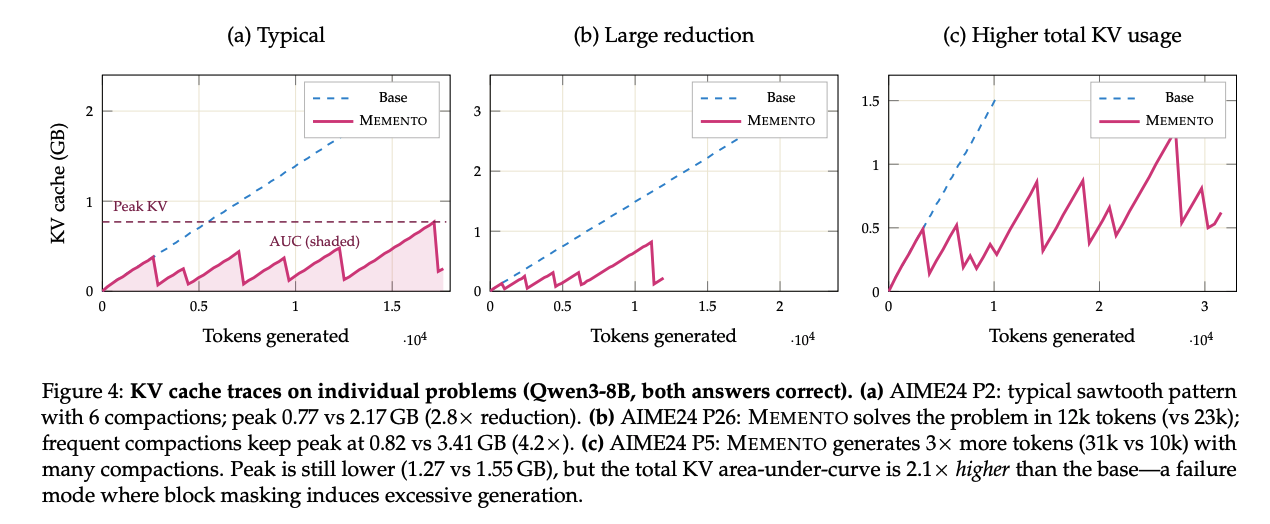
메모리 사용량이 시간에 따라 어떻게 변하는지 보여주며, Base는 시간이 지남에 따라 꾸준히 증가하지만 Memento는 압축하기에 증가와 감소하는 모습이 반복적으로 일어나는 것을 볼 수 있다.
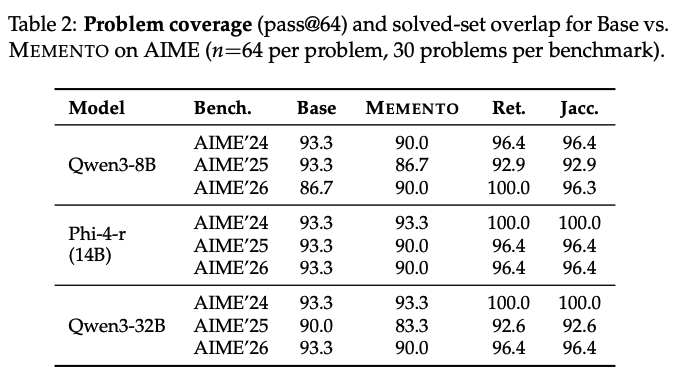
Memento는 많은 문제에서 정답을 생성할 가능성을 가지고 있지만 정답을 일관되게 생성하는 능력이 약해졌다는 결과가 나왔으.ㅁ
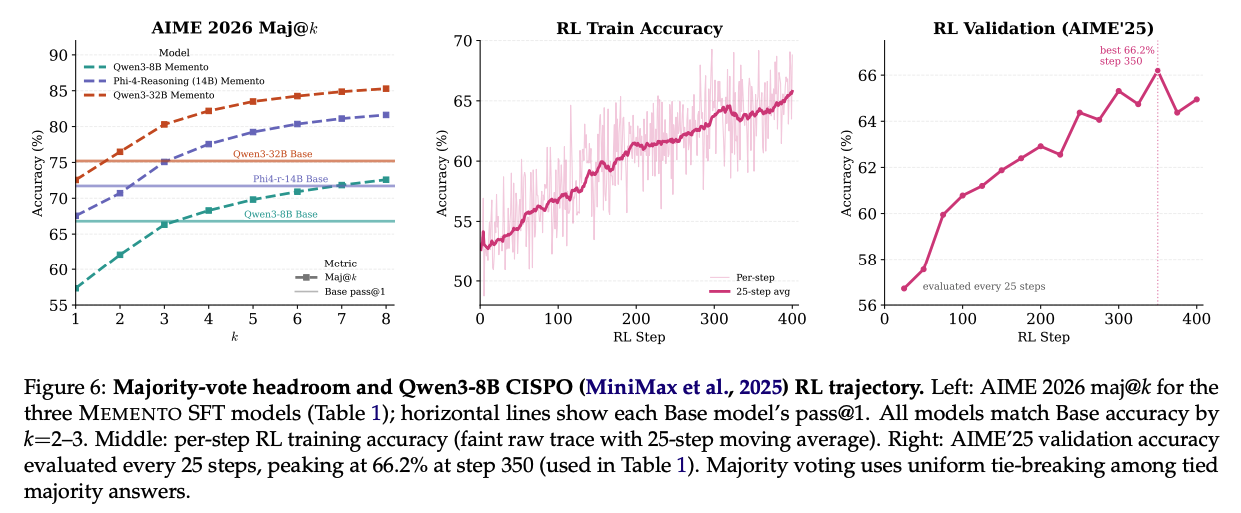
RL 과정을 통해 정확도가 상승한 것을 볼 수 있다.
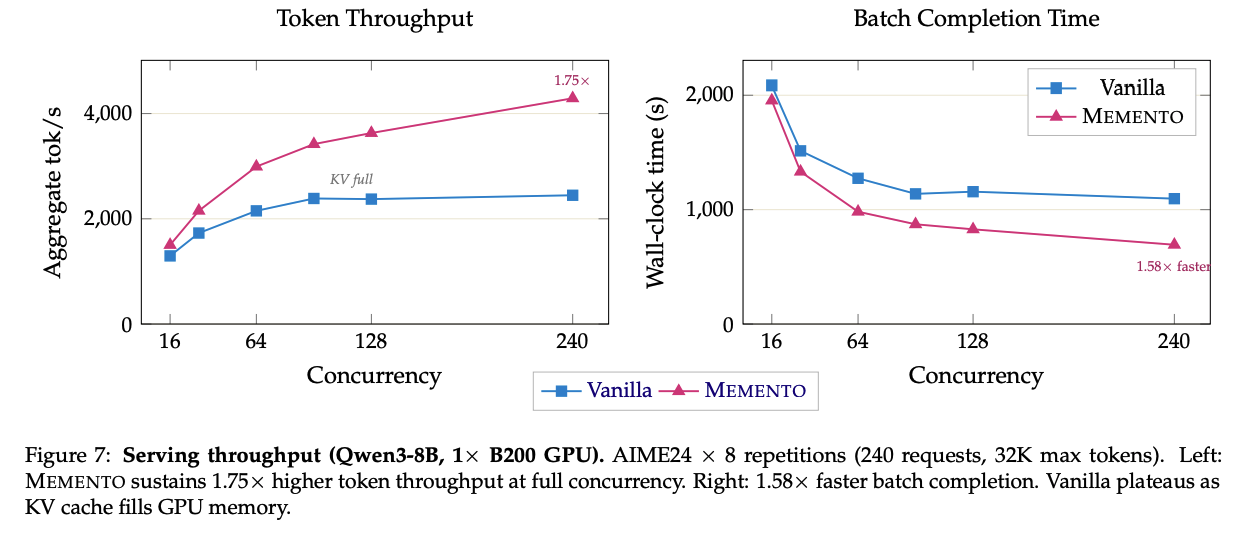
Memento는 완료된 Thinking Block의 KV cache를 지속해서 제거했기에 더 많은 요청을 동시에 처리할 수 있었음
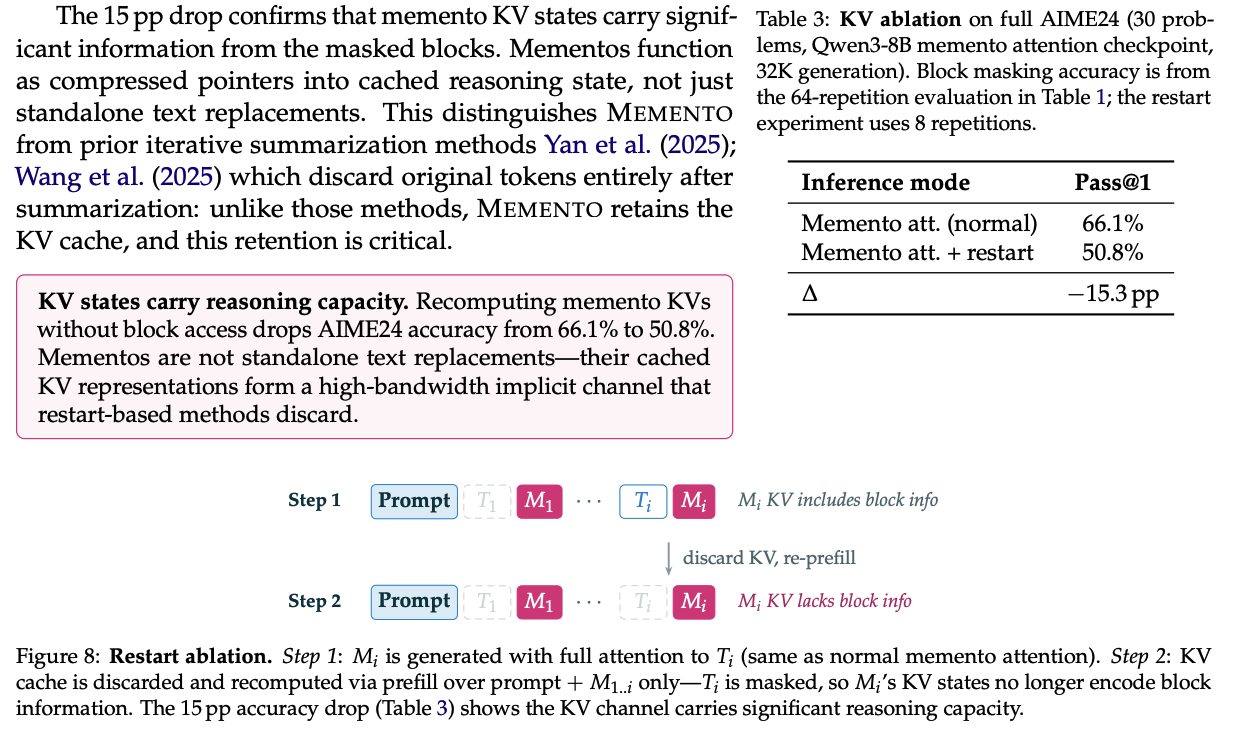
Memento의 KV cache를 제거하고 다시 채워넣었을 때 성능 하락을 볼 수 있었다.
이를 통해 KV cache의 중요성을 볼 수 있었다.
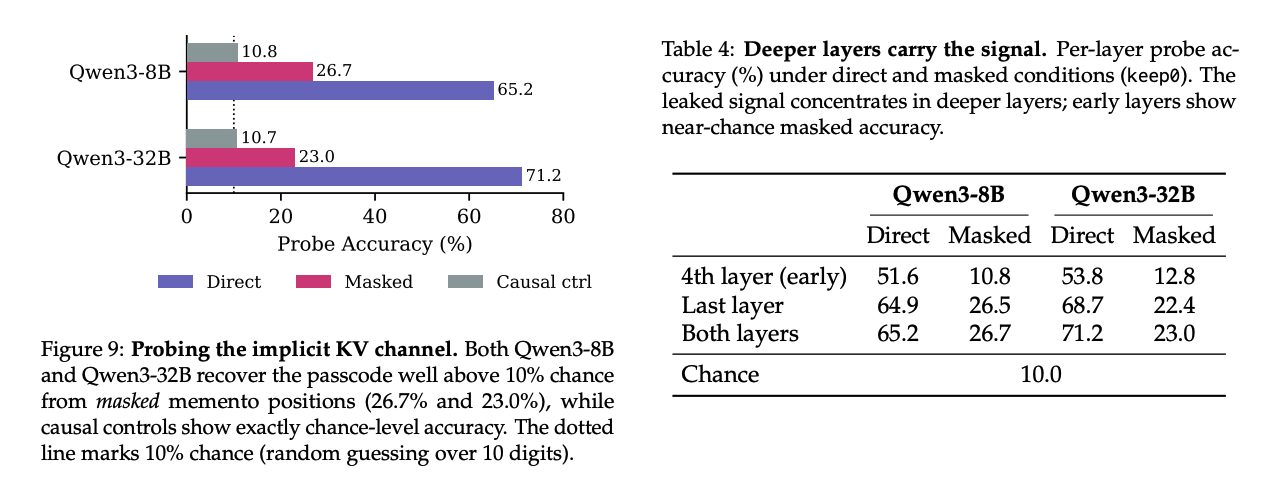
추론 과정에 숫자를 숨기고, Memento를 만든 뒤 물어보면 KV state를 통해 일부 복구된다는 사실을 알 수 있었다.
| 연구 목적 | Reasoning LLM이 긴 Chain-of-Thought(CoT)를 생성하면서 모든 과거 토큰과 KV Cache를 유지하는 비효율 해결 | 모델이 외부 요약 시스템 없이 자신의 Context를 직접 관리하도록 학습 |
| 기존 방법의 한계 | 기존 추론 압축 방법은 추론을 짧게 생성하거나 이전 추론을 텍스트로 요약한 후 새로운 Context에서 재시작함 | 텍스트 요약 과정에서 중요한 정보가 누락될 수 있으며, 기존 추론을 참조하여 형성된 Contextualized KV 정보도 손실 |
| 핵심 아이디어 | 긴 추론을 여러 Thinking Block 으로 분할하고, 각각을 압축한 자연어 요약 Memento 생성 | 과거 Thinking Block은 제거하고, Memento 텍스트와 해당 KV Cache를 유지하여 다음 추론 수행 |
| 방법론: Memento Attention | 현재 Thinking Block이 완료되면 Memento를 생성하고, 이후 해당 Thinking Block에 대한 Attention을 차단 | 후속 추론은 Prompt + 이전 Mementos + 현재 Thinking Block에 접근. 생성 당시의 Memento KV는 재계산하지 않고 유지 |
| 데이터셋 구축 | OpenMementos: OpenThoughts-v3를 기반으로 228K Reasoning Traces 생성. Math 54%, Code 19%, Science 27% |
LLM 기반 경계 점수화 → 구간 최적화 → 요약 생성 → Judge 피드백. 요약 품질 통과율 28% → 92% |
| 추론 압축 | 원본 Reasoning Block의 핵심 수식, 변수, 중간 결과, 전략을 Memento에 압축 | 학습 데이터 평균 1,150 → 194 tokens, 약 5.9배 압축. 실제 생성 시 대부분의 블록은 약 5–20배 압축 |
| 학습 방식 | Stage 1: Full Attention SFT로 Block–Memento 생성 형식 학습. Stage 2: Block-masked Attention SFT로 과거 추론 없이 이어가는 방법 학습 |
기존 Reasoning 모델은 31K 샘플로 2-stage SFT. 두 단계 모두 일반적인 LM Loss를 사용하며 Attention 구조만 변경 |
| 추가 학습: RL | CISPO 기반 Reinforcement Learning으로 압축에 따른 정확도 감소를 보완 | Qwen3-8B AIME'26: 57.3% → 64.9%. 다만 RL 후 일부 KV Cache 사용량 증가 |
| 핵심 기여: Dual Information Stream | Memento에는 ① Explicit Information(요약 텍스트)과 ② Implicit Information(원본 추론을 참조하면서 생성된 KV 상태)이 함께 존재 | 요약 텍스트가 동일하더라도 KV 생성 당시의 Context에 따라 이후 추론 성능이 달라짐 |
| KV Causal Ablation | Memento의 텍스트는 유지하되, 기존 KV Cache를 버리고 원본 Thinking Block 없이 KV를 다시 계산하는 Restart 실험 | Qwen3-8B AIME24: 66.1% → 50.8% (−15.3%p). 원본 추론을 참조하여 형성된 KV 상태가 실제 추론 성능에 기여함을 실증 |
| KV Information Probing | Thinking Block에 임의의 5자리 숫자를 삽입하고, 제거된 블록의 정보가 후속 Memento KV에 남아 있는지 MLP Probe로 검사 | 숫자 각 자리의 예측 정확도: Qwen3-8B 26.7%, Qwen3-32B 23.0% (무작위 10%). 특히 깊은 레이어에서 정보가 더 많이 복원됨 |
| 추론 정확도 | AIME, MATH-500, GPQA-Diamond, LiveCodeBench 등에서 Qwen3, Phi-4, Olmo 3 평가 | Qwen3-32B AIME'26: 75.2% → 72.6% (−2.6%p). 모델 규모가 커질수록 정확도 손실이 감소하는 경향 |
| 메모리 효율 | 완료된 Thinking Block의 KV Cache를 물리적으로 제거하고 Memento KV만 유지 | 일반 Full Attention 구조에서 Peak KV Cache 약 2–3배 감소, KV AUC 최대 3.5배 감소 |
| 시스템 구현 | vLLM V1 엔진을 확장하여 생성 도중 동적으로 KV Cache를 제거하고 재배치하는 Block Masking 구현 | Qwen3-8B, 단일 B200 GPU, 240개 요청에서 Throughput 1.75배 증가, 배치 완료 시간 약 1.58배 단축 |
| 한계점 | 압축에 따른 정확도 감소, RL 이후 압축 효율 일부 저하, 불필요하게 긴 추론 생성 가능성 존재 | Sliding-window 구조에서는 메모리 절약 효과가 제한적. Long-horizon Agent 및 복잡한 관계 정보 보존에 대한 검증 부족 |
| 최종 결론 | LLM의 추론 메모리는 단순한 텍스트 요약이 아니라, 요약을 생성할 당시의 문맥화된 KV 상태까지 포함한다. | 자연어 기반 추론 압축과 내부 KV Representation의 보존을 결합하여 효율적인 Long-horizon Reasoning의 가능성을 제시 |