https://aclanthology.org/2021.findings-emnlp.161/
Span Pointer Networks for Non-Autoregressive Task-Oriented Semantic Parsing
Akshat Shrivastava, Pierce Chuang, Arun Babu, Shrey Desai, Abhinav Arora, Alexander Zotov, Ahmed Aly. Findings of the Association for Computational Linguistics: EMNLP 2021. 2021.
aclanthology.org
21년 emnlp findings 였네요.
입력 문장을 다시 생성하지 말고 스팬의 처음 끝 위치만 출력하도록 진행했습니다.
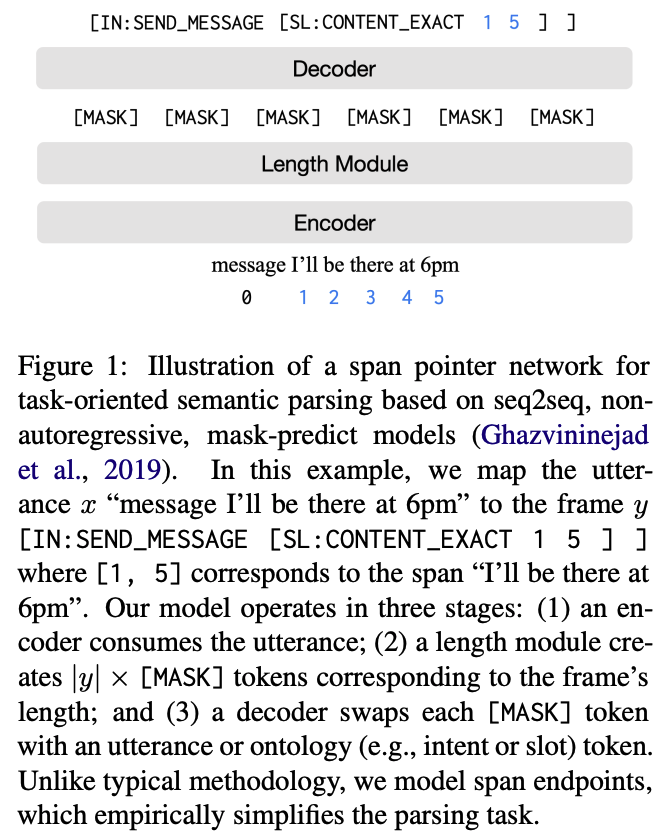
여기서 디코더는 Auto regressive model이 아니기 때문에 길이를 예측하고, 한꺼번에 생성해야 한다.
Mask-Predict NAR parser - Encoder가 input 인코딩하여 Length Module이 출력 길이를 예측하고, 예측 된 [MASK]만큼 decoder가 병렬로 채우게 된다.
여기서 LENGTH MODULE가 너무 어려움. 디코더가 무엇을 생성할지 정하기도 전에 길이를 제한해야 함.
text generation -> span prediction으로 변형하여 해결
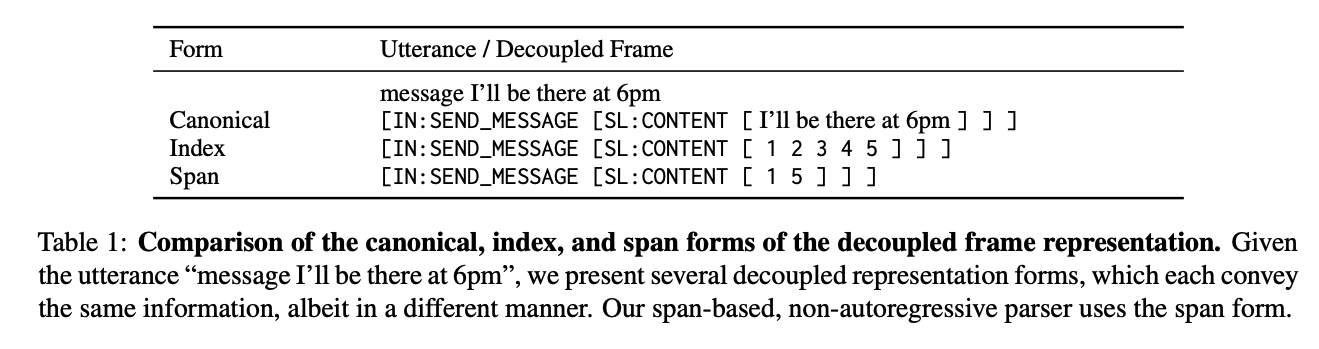
3가지 방식으로 표현함.
일반 출력, index 출력, 스팬 출력으로 간다.
길이 loss와 label loss를 혼합하여 학습한다.
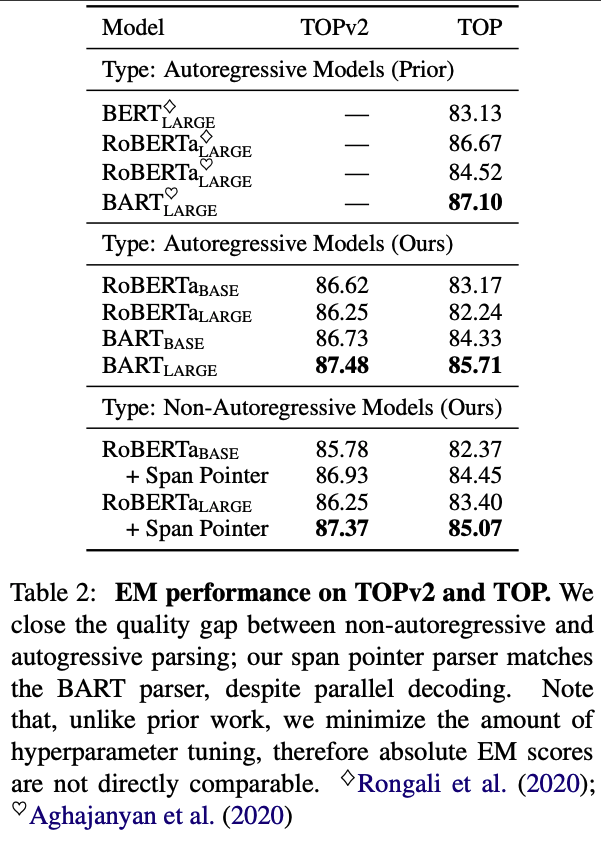
정확도가 약간 상승하는 것을 보인다. Autoregressive 모델이랑 비교를 하네요
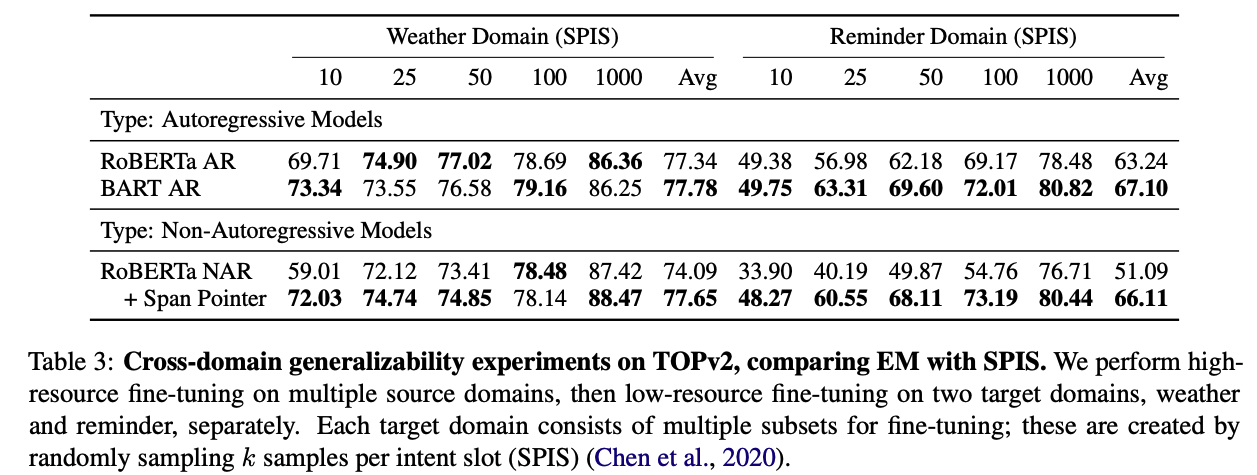
복잡하고 데이터가 적은 상황일수록 모델이 자연어를 생성하기 보다 포인터로 위치만 생성하는게 이득이 컸습니다.
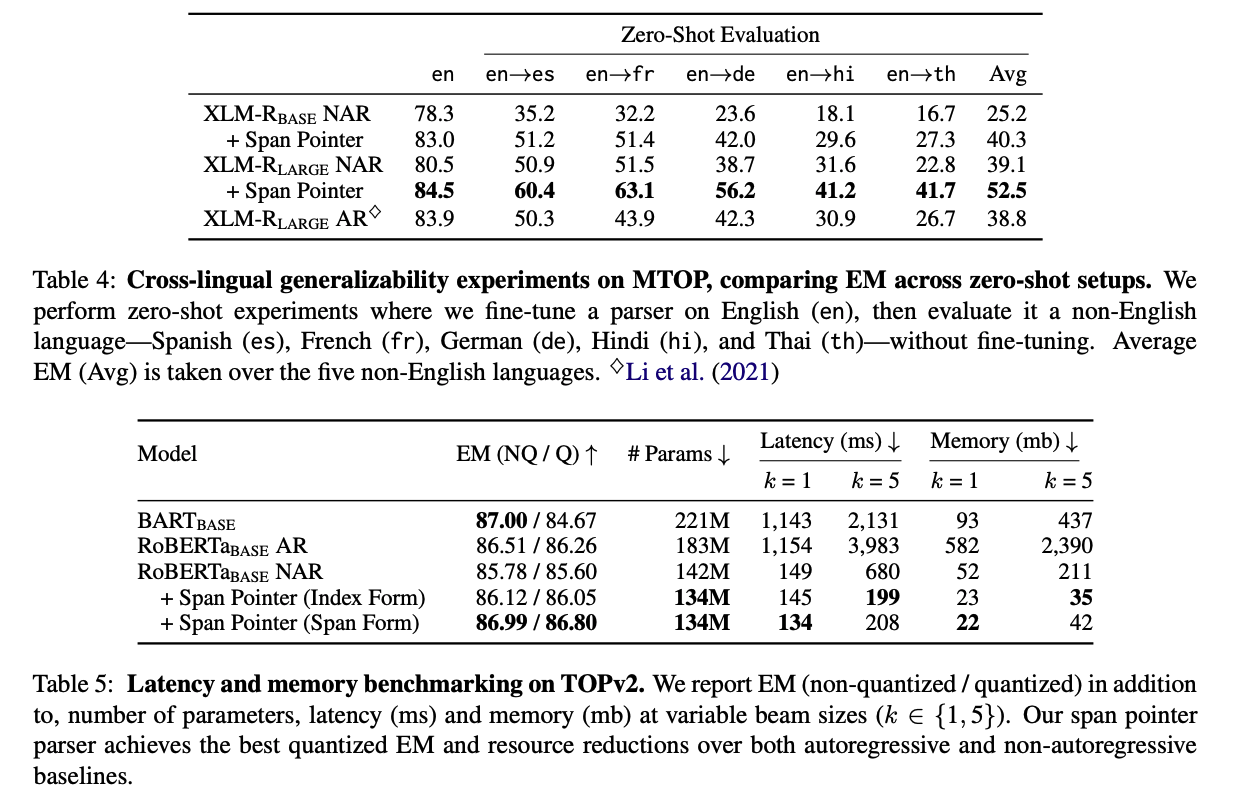
다국어에서 좋은 성능을 보였습니다. - Language independent를 보인다고 저자는 말합니다.
메모리와 시간은 대폭 줄이면서 성능은 올렸스빈다.

모델을 더 복잡하게 만들기 보다는 출력을 테스크 구조에 맞게 진행하면 어려운 문제도 쉽게 변환할 수 있다가 핵심 메세지였습니다.
| 논문명 | Span Pointer Networks for Non-Autoregressive Task-Oriented Semantic Parsing — Task-Oriented Semantic Parsing에서 실제 텍스트를 생성하는 대신 입력 문장의 span 위치를 pointer로 예측하는 비자기회귀(NAR) 파서를 제안한다. |
| 해결하려는 문제 | 기존 NAR semantic parser는 먼저 출력 frame 길이를 예측한 뒤 그 수만큼 [MASK]를 생성한다. 이때 slot 내부의 자연어 argument 길이까지 미리 맞춰야 하므로, length prediction이 주요 병목이 되고 단 1개의 길이 오류도 frame의 syntax와 semantics를 망가뜨릴 수 있다. |
| 핵심 아이디어 | Slot value를 직접 생성하지 않고 입력 내 시작·끝 위치 (start, end)를 출력한다. 예: "I'll be there at 6pm" → [1, 5]. 즉 Text Generation → Span Prediction으로 문제를 변환한다. |
| 기존 방식 예시 | message I'll be there at 6pm → [IN:SEND_MESSAGE [SL:CONTENT_EXACT I'll be there at 6pm]]처럼 입력에 이미 존재하는 텍스트를 decoder가 다시 생성해야 한다. |
| 제안 방식 예시 | 동일한 입력을 [IN:SEND_MESSAGE [SL:CONTENT_EXACT 1 5]]로 표현한다. [1,5]는 입력의 "I'll be there at 6pm" 구간을 가리킨다. |
| Frame Representation | 세 형태를 비교한다. Canonical: 실제 text / Index: 1 2 3 4 5 / Span: 1 5. 최종적으로 Span Form을 사용하며, 긴 argument도 항상 두 endpoint로 압축할 수 있다. |
| 왜 NAR에 유리한가? | Canonical 방식에서는 Length Module이 frame syntax + argument semantics/길이까지 암묵적으로 예측해야 한다. Span 방식에서는 argument 길이가 거의 고정된 두 index로 표현되므로 Length Module은 주로 syntax, Decoder는 실제 semantic span을 담당한다. 저자들은 이를 coarse-to-fine modeling으로 해석한다. |
| 모델 구조 | Encoder → Length Module → NAR Decoder. Encoder는 RoBERTa/XLM-R 등의 pretrained Transformer, Length Module은 frame 길이를 예측하고, Decoder는 모든 [MASK]를 병렬적으로 채운다. |
| Pointer-Generator 구조 | Decoder는 두 종류의 출력을 사용한다. Ontology token(intent/slot)은 generate하고, utterance span은 input position index를 pointer처럼 출력한다. Copy vocabulary는 일반 단어 vocabulary가 아니라 {0, …, max_input_index}로 제한된다. |
| 학습 Objective | Frame length를 위한 L_length와 최종 frame token 예측을 위한 L_label을 함께 학습하여 L_NAR = L_label + λ_1L_length로 최적화한다. Label smoothing과 R3F도 사용한다. |
| 평가 데이터 / 지표 | TOP, TOPv2, MTOP에서 평가하며, 주요 지표는 Exact Match(EM)이다. 추가로 cross-domain, cross-lingual transfer 및 latency/memory를 평가한다. |
| Main Quality Result | TOPv2에서 RoBERTa-Large NAR가 86.25 → 87.37 EM, TOP에서는 83.40 → 85.07 EM으로 향상된다. BART-Large AR의 87.48 / 85.71과 매우 근접하여 NAR와 AR 사이의 품질 격차를 크게 줄인다. |
| Low-resource Domain Transfer | TOPv2의 Weather/Reminder 저자원 domain adaptation에서 기존 NAR보다 크게 향상된다. 예를 들어 Reminder 25 SPIS에서 40.19 → 60.55 EM, 50 SPIS에서 49.87 → 68.11 EM이다. |
| Cross-lingual 결과 | 영어로만 학습한 뒤 Spanish/French/German/Hindi/Thai로 zero-shot transfer했을 때 XLM-R-Large NAR의 평균 EM이 39.1 → 52.5로 크게 증가한다. Span representation이 언어별 surface-form 길이 차이를 제거하기 때문이다. |
| 효율성 | Beam size 5에서 기존 RoBERTa NAR는 680 ms / 211 MB, Span Pointer는 약 208 ms / 42 MB로 감소한다. 저자는 기존 NAR 대비 약 3.2× latency 감소, 4.9× memory 감소를 보고한다. |
| 왜 효율적인가? | ① 50K–250K 규모의 subword vocabulary 대신 input position 중심의 작은 vocabulary를 사용하고, ② 긴 text argument도 (start,end) 두 token으로 압축할 수 있기 때문이다. |
| 핵심 분석 1: Length Class | TOPv2에서 Canonical representation의 output length class는 47개, Span Form은 20개로 줄어든다. 즉 동일한 frame 구조가 더 일관된 길이를 갖게 되어 length prediction이 쉬워진다. |
| 핵심 분석 2: Syntax vs. Semantics | Leaf argument를 제거한 syntax-only 조건에서는 NAR가 AR과 동등하거나 더 높은 성능을 보인다. 반대로 semantics까지 생성하면 NAR가 크게 하락한다. 이는 NAR의 핵심 병목이 leaf argument generation임을 보여준다. |
| 논문의 가장 중요한 기여 | 새로운 거대한 architecture보다는 출력 표현 자체를 바꿔 generation 문제를 reference/pointer prediction 문제로 단순화했다는 점이다. 이를 통해 accuracy, transfer, latency, memory를 동시에 개선한다. |
| 한계 | 기본적으로 연속된 span(contiguous span)을 가정한다. 논문도 future work로 discontinuous span 처리 필요성을 언급한다. |
| 한 줄 요약 | “입력에 이미 있는 텍스트를 다시 생성하지 말고, 어디에 있는지만 가리키자.” 이 representation 변경만으로 NAR semantic parsing의 length bottleneck을 크게 완화한다. |